KIẾN TRÚC MULTI-AGENT VÀ HẠ TẦNG LLMOPS CHUYÊN SÂU
Trong giai đoạn đầu của làn sóng Generative AI, phần lớn các ứng dụng phần mềm đều dừng lại ở mô hình tương tác một - một: người dùng gửi câu hỏi và mô hình ngôn ngữ lớn phản hồi kết quả. Tuy nhiên, khi đối mặt với các bài toán vận hành phức tạp của doanh nghiệp — nơi một quy trình đòi hỏi sự phối hợp qua lại giữa nhiều bước: nghiên cứu dữ liệu, đối soát bảng biểu, gọi API bên ngoài, kiểm duyệt tính hợp lệ và phê duyệt qua nhiều cấp — một câu lệnh prompt đơn lẻ hoàn toàn bất lực.
Sự chuyển dịch mang tính đột phá của kỹ nghệ AI hiện đại nằm ở hai trụ cột song hành: Multi-Agent Systems (Hệ sinh thái Đa tác tử tự trị) chịu trách nhiệm điều phối suy luận logic ở tầng ứng dụng, và LLMOps (Hạ tầng vận hành mô hình lớn) chịu trách nhiệm phục vụ suy luận thông lượng cao, kiểm soát độ trễ và quản trị chi phí phần cứng ở tầng máy chủ.
Bài viết này sẽ phẫu thuật chi tiết tư duy kiến trúc và quy trình triển khai toàn diện của hai khối công nghệ cốt lõi này.
1. Giới Hạn Của Single Agent Và Sự Trỗi Dậy Của Đồ Thị Trạng Thái LangGraph
Các thư viện Agent thế hệ đầu tiên thường vận hành theo cấu trúc chuỗi tuần tự tuyến tính hoặc vòng lặp tự do dựa trên mô hình ReAct (Reasoning and Acting). Khi ứng dụng vào thực tế, kiến trúc này bộc lộ ba nhược điểm chí mạng:
Rủi ro vòng lặp vô tận (Infinite Loops): Agent liên tục kích hoạt một công cụ thất bại nhiều lần mà không có cơ chế rẽ nhánh an toàn để thoát khỏi trạng thái tắc nghẽn.
Mất kiểm soát trạng thái dữ liệu (State Loss): Dữ liệu trung gian giữa các bước thực thi dễ bị ghi đè hoặc bị mô hình viết lại làm sai lệch, khiến các bước xử lý sau không có đủ căn cứ để ra quyết định.
Quá tải công cụ (Tool Overload): Khi nhồi nhét hơn 10 công cụ vào một Agent duy nhất, năng lực suy luận của mô hình bị suy giảm nghiêm trọng, tỷ lệ chọn sai công cụ hoặc sinh tham số lỗi tăng vọt.
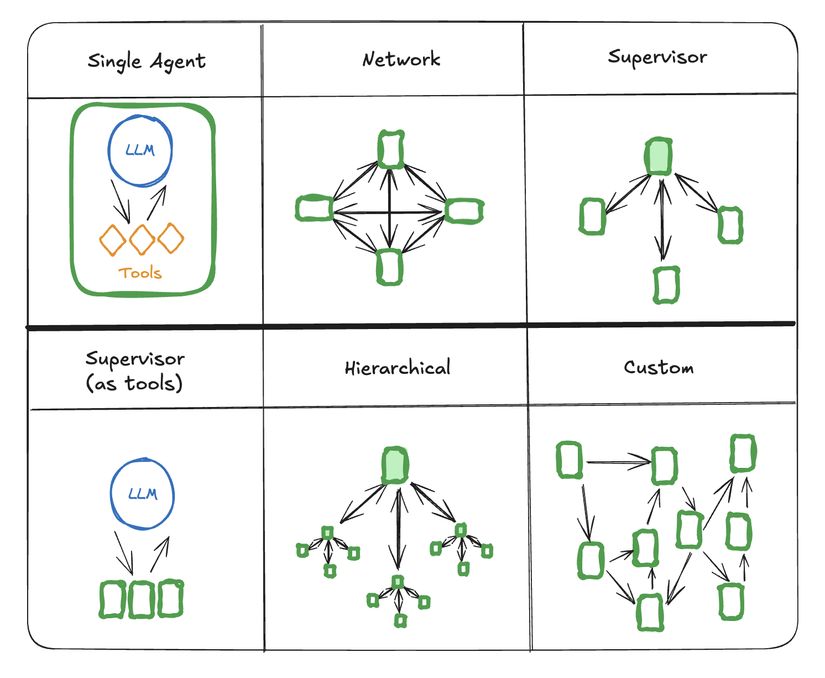
Khung điều phối LangGraph giải quyết triệt để các vấn đề này bằng cách mô hình hóa hệ thống dưới dạng một Đồ thị có hướng (Directed Graph) kết hợp máy trạng thái hữu hạn:
Trạng thái tập trung (Shared State Schema): Định nghĩa một cấu trúc dữ liệu nghiêm ngặt bằng Pydantic lưu trữ toàn bộ lịch sử đối thoại, dữ liệu trung gian trích xuất từ các công cụ và các cờ trạng thái kiểm duyệt truyền qua lại giữa các Node.
Các điểm nút độc lập (Nodes): Mỗi Node đại diện cho một Agent chuyên biệt sở hữu vai trò riêng (Planning Agent, Execution Agent, Reviewer Agent) hoặc một hàm thực thi công cụ phần mềm độc lập.
Các cạnh điều kiện (Conditional Edges): Chứa các biểu thức logic xác định hướng di chuyển tiếp theo của luồng xử lý dựa trên kết quả trả về của Node hiện tại, cho phép hệ thống tự động quay lui sửa lỗi hoặc rẽ nhánh xử lý ngoại lệ.
Cơ chế con người tham gia kiểm duyệt (Human-in-the-loop): Thiết lập các điểm dừng chờ ngắt quãng (Interrupt Points) trước những hành động nhạy cảm (như gửi email báo giá cho khách hàng hoặc cập nhật số dư tài khoản), gửi thông báo cho người quản trị phê duyệt trên giao diện trước khi Agent tiếp tục chu trình thực thi.
2. Kỹ Nghệ Định Nghĩa Bộ Công Cụ Với Pydantic Và Kiểm Soát Ngoại Lệ
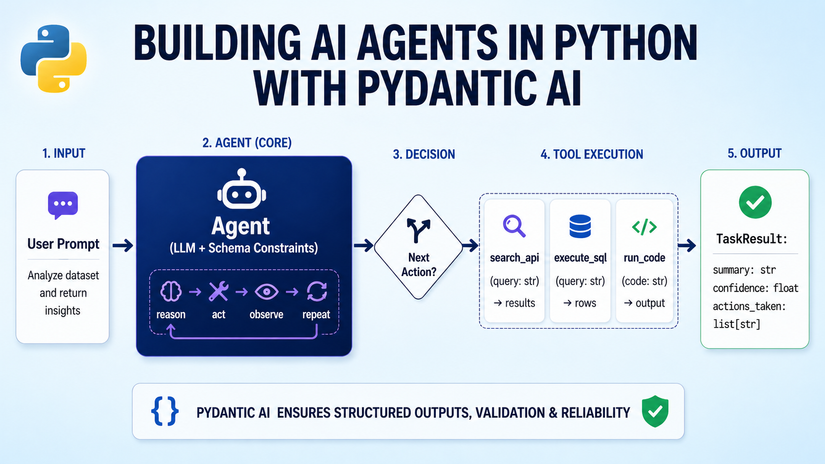
Để các Agent tương tác chuẩn xác với các phần mềm khác, kỹ thuật Function Calling đòi hỏi tính kỷ luật rất cao:
Định nghĩa Schema tham số nghiêm ngặt: Mọi tham số đầu vào và đầu ra của công cụ phải được đặc tả kiểu dữ liệu rõ ràng thông qua Pydantic, đi kèm các ràng buộc hợp lệ (ví dụ: chuỗi ngày tháng phải đúng định dạng ISO, giá trị số tiền phải lớn hơn 0).
Mô tả công cụ chuyên sâu (Tool Descriptions): LLM không đọc code của hàm mà chỉ đọc phần docstring mô tả. Kỹ sư phải viết phần mô tả thật chi tiết: công cụ này dùng để làm gì, khi nào nên sử dụng và khi nào tuyệt đối không được kích hoạt.
Bọc khối kiểm soát lỗi toàn diện: Toàn bộ các hàm công cụ gọi ra bên ngoài (truy vấn SQL, gọi REST API) bắt buộc phải được bọc trong cấu trúc try-except. Khi API bên ngoài bị nghẽn mạng hoặc trả về mã lỗi 500, hàm phải trả về thông điệp lỗi có cấu trúc để Agent đọc hiểu nguyên nhân và tự động thử lại bằng phương án thay thế, ngăn chặn việc toàn bộ hệ thống bị sập đột ngột.
3. Tối Ưu Hóa Hạ Tầng Suy Luận Mô Hình Lớn Với vLLM Trên Cụm GPU
Đưa các mô hình mã nguồn mở (như Llama 3, Qwen, DeepSeek) lên máy chủ GPU phục vụ người dùng thực tế là một bài toán hóc búa về chi phí và tài nguyên phần cứng. Nếu sử dụng các framework thông thường, hệ thống sẽ nhanh chóng bị tràn bộ nhớ VRAM và tắc nghẽn thông lượng khi có vài chục yêu cầu đồng thời.
Động cơ suy luận hiệu năng cao vLLM giải quyết triệt để bài toán này bằng ba đột phá công nghệ:
Thuật toán PagedAttention: Trong quá trình mô hình tự hồi quy sinh từng ký tự mới, bộ nhớ đệm KV Cache liên tục phình to. Các framework cũ buộc phải cấp phát các khối bộ nhớ liên tục có kích thước bằng độ dài tối đa, gây lãng phí tới 70% VRAM do phân mảnh bộ nhớ. PagedAttention phân chia KV Cache thành các khối trang bộ nhớ ảo không cần liên tục về mặt vật lý, nâng tỷ lệ khai thác hữu ích của VRAM lên tiệm cận 96%.
Cơ chế ghép mẻ liên tục (Continuous Batching): Thay vì phải đợi toàn bộ các câu trong một mẻ xử lý hoàn thành việc sinh từ rồi mới nhận yêu cầu mới, cơ chế Continuous Batching cho phép chèn ngay các yêu cầu mới vào các khe trống tính toán ngay khi có một câu trong mẻ vừa kết thúc, giúp các nhân Tensor Core trên GPU luôn hoạt động ở công suất tối đa.
Kỹ thuật lượng tử hóa trọng số (Quantization): Ứng dụng các thuật toán nén hiện đại như AWQ (Activation-aware Weight Quantization) hoặc FP8 để giảm kích thước trọng số từ 16-bit xuống 4-bit hoặc 8-bit, giúp nạp vừa các mô hình quy mô lớn vào các dòng máy chủ GPU phổ thông mà gần như bảo toàn trọn vẹn năng lực nhận thức của mô hình.
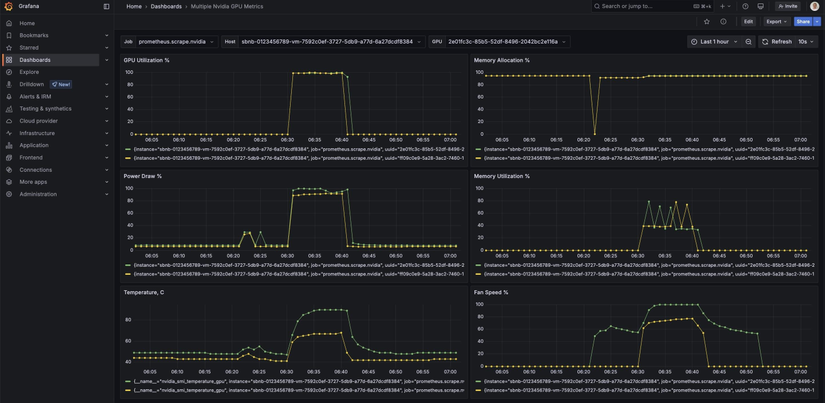
4. Giám Sát Phân Tán LLMOps, AI Guardrails Và Tối Ưu Chi Phí Vận Hành
Vận hành một hệ sinh thái AI trong môi trường sản xuất đòi hỏi hệ thống giám sát và bảo vệ toàn diện:
Lưu vết phân tán toàn diện (Distributed LLM Tracing): Tích hợp các công cụ quan sát chuyên dụng như LangSmith, Arize Phoenix hoặc OpenTelemetry để ghi lại chi tiết cây phân nhánh thực thi của từng câu truy vấn, đo lường chính xác thời gian phản hồi ký tự đầu tiên (TTFT) và tốc độ sinh các ký tự tiếp theo (TPOT).
Hàng rào bảo vệ an toàn (AI Guardrails): Cài đặt các lớp kiểm duyệt đầu vào độc lập để ngăn chặn các cuộc tấn công tiêm nhiễm câu lệnh (Prompt Injection), đồng thời thiết lập cơ chế tự động che giấu thông tin cá nhân nhạy cảm (PII Masking) trước khi nạp dữ liệu vào cửa sổ ngữ cảnh của mô hình.
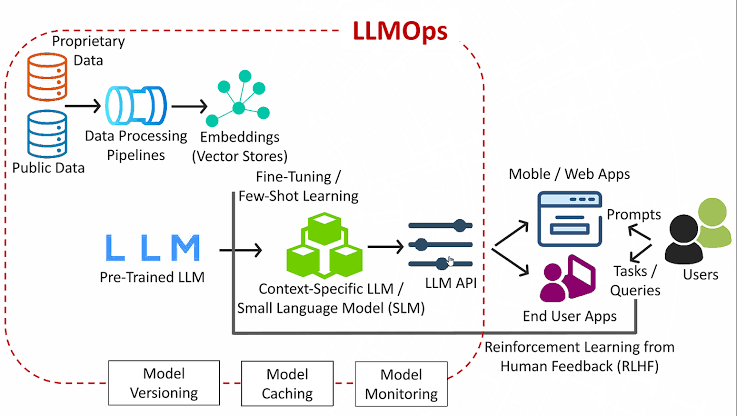
Tối ưu hóa chi phí bằng Semantic Caching: Lưu trữ các cặp câu hỏi - câu trả lời trong quá khứ vào một cơ sở dữ liệu vector tốc độ cao (như Redis hoặc Qdrant). Khi có truy vấn mới sở hữu độ tương đồng ngữ nghĩa vượt ngưỡng 0.95 so với câu hỏi cũ, hệ thống lập tức trả về câu trả lời có sẵn với độ trễ dưới 20 mili-giây và chi phí điện toán bằng 0.
Làm chủ toàn bộ chuỗi công nghệ từ việc điều phối đồ thị trạng thái LangGraph, viết schema công cụ chuẩn xác cho đến việc thiết lập hạ tầng vLLM và giám sát LLMOps trên máy chủ GPU thực tế là năng lực cốt lõi giúp bạn trở thành một Kỹ sư AI đắt giá trên thị trường công nghệ. Để rút ngắn hàng trăm giờ tự mày mò thử sai và tiếp cận phương pháp luận chuẩn công nghiệp dưới sự dẫn dắt từ các chuyên gia giải pháp hàng đầu.
Hãy dừng ngay việc xây dựng các ứng dụng AI đồ chơi trên máy tính cá nhân. Hãy bắt tay vào chuẩn hóa đồ thị trạng thái tác tử, cấu hình động cơ vLLM và thiết lập đường ống giám sát LLMOps cho dự án của bạn ngay hôm nay!
#cole #colevn #coleblogvn #MultiAgent #LLMOps
All Rights Reserved