Jev là gì: mô hình AI trả về xác suất thay vì text, và vì sao điều đó quan trọng khi build agent
Vấn đề: agent cần ra quyết định nhanh, không cần sinh văn bản
Một coding agent chuẩn bị chạy npm run db:reset. Nếu task là "xóa database dev rồi seed lại" thì đúng. Nếu task là "thêm cột last_login" thì lệnh đó đang phá dữ liệu. Một regex không phân biệt được hai trường hợp này vì câu lệnh giống hệt nhau.
Cách xử lý phổ biến: gọi lại một frontier LLM để hỏi "lệnh này có ổn không?" — tốn vài cent, vài giây mỗi lần, và một agent session thật gọi hàng trăm lần như vậy trong một phiên làm việc. Đây chính là bài toán mà Jev, mô hình do TypeSafe AI ra mắt ngày 15/09/2026, được thiết kế để giải quyết.
Jev khác LLM ở điểm nào
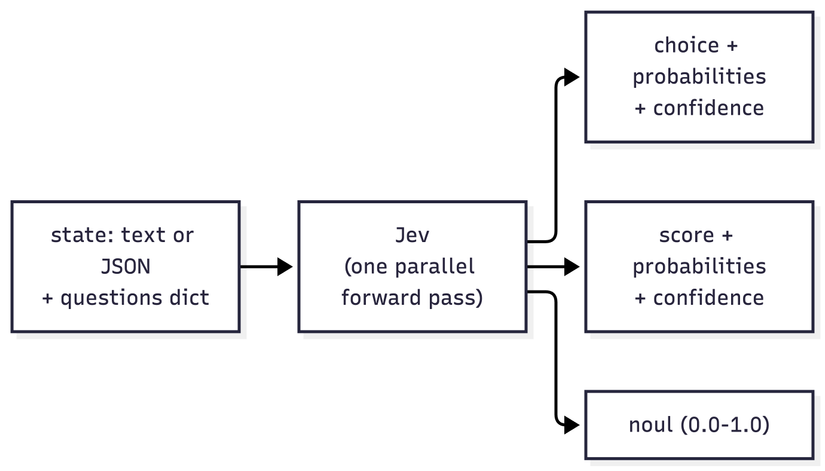
Jev là một System One Model: nhận vào một state (text hoặc JSON có sẵn) cộng một dictionary questions, trả về xác suất calibrated cho từng câu hỏi trong một forward pass duy nhất — không sinh token tuần tự như LLM thông thường.
Có đúng 3 kiểu câu hỏi:
| Kiểu | Input | Output |
|---|---|---|
Choice |
Danh sách lựa chọn | 1 lựa chọn + xác suất cho từng lựa chọn + confidence score |
Score |
Thang điểm | Điểm số + xác suất cho từng mức + confidence score |
Noul |
Câu hỏi yes/no | 1 xác suất từ 0.0 đến 1.0 |
Request mẫu (từ docs của TypeSafe):
{
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP.",
  "model": "jev-latest",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this",
      "criteria": {
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions"
      }
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}
Response:
{
  "answers": {
    "department": {
      "choice": "technical",
      "probabilities": { "billing": 0.159, "technical": 0.84, "sales": 0.001 },
      "confidence": 0.596
    },
    "is_urgent": { "noul": 0.999 }
  },
  "usage": { "input_tokens": 312, "output_tokens": 48 }
}
department.choice chắc chắn là một trong các key đã khai báo. Không cần parse, không cần retry, không cần JSON-repair.
Case study thực tế: pi-warden
pi-warden, một guardrail cho coding agent xây trong 48 giờ đầu sau khi Jev ra mắt, gửi 4 câu hỏi có kiểu tới Jev trước mỗi lệnh bash/write/edit: có thể đảo ngược không, có lạc task không, có thay đổi gì không, phạm vi là gì — trả về trong khoảng 250ms. Theo số liệu của người maintain: qua 17.000 lượt gọi, chặn 42 lần, khoảng 88% số lần chặn là đúng.
Số liệu: của vendor và độc lập
| Tuyên bố | Nguồn | Độc lập? |
|---|---|---|
| $0.042/MTok input, output free, latency 70–500ms | TypeSafe launch post | Không |
| Nhanh hơn 193.6x, rẻ hơn 444.6x | TypeSafe homepage, 4 workflow eval nội bộ | Không — cả test lẫn reference đều do vendor dựng |
| Rẻ hơn 580x, bắt 6/7 lỗi (Fable: 7/7) | Every.to (Dan Shipper) | Có |
TypeSafe tự thừa nhận trong bài công bố: reference (trung bình output của GPT-6 Astra và Fable 5.1) lệch về phía OpenAI/Anthropic, workflow do chính nhân viên họ dựng, và mức tăng "nằm ở cận trên" so với thực tế. Thread Hacker News (1.821 điểm) cũng bị đổi tên trong vòng 1 giờ sau khi một comment chỉ ra so sánh 70ms với 3–329 giây là khập khiễng nếu LLM không làm công việc tương đương.
"Không hallucinate" — cần hiểu đúng phạm vi
Con số 0% hallucination của Jev không phải số liệu thực nghiệm — nó được đảm bảo bằng cấu trúc: cho 3 lựa chọn thì không thể trả về lựa chọn thứ 4. Đó là schema matching, không phải độ chính xác. Jev vẫn có thể chọn sai trong 3 lựa chọn hợp lệ. Ba nguồn độc lập (top comment Hacker News, The Register, KDnuggets) đều nói rõ: "zero hallucination" gần với "zero out-of-schema output" hơn là "zero quyết định sai."
Checklist khi cân nhắc dùng Jev
- Jev không sinh text — chỉ trả về
choice/score/noul. Nếu cần output là văn xuôi hay code, đây không phải công cụ phù hợp. - Kiến trúc, số tham số, dữ liệu training: chưa công bố. Không có cơ sở để khẳng định vì sao nó nhanh.
- Số liệu tốc độ/chi phí nổi bật nhất là benchmark tự làm, tự chấm của vendor. Ưu tiên số liệu độc lập (Every.to) khi đánh giá thực tế.
- "Không hallucinate" = không trả về ngoài schema, không phải luôn luôn đúng.
All Rights Reserved