HƯỚNG DẪN CHUYỂN HÓA DATA LAKE THÀNH LAKEHOUSE VỚI APACHE ICEBERG VÀ MINIO/S3 CHUẨN PRODUCTION
Trong hơn một thập kỷ qua, kiến trúc Data Lake (Hồ dữ liệu) lưu trữ các file Parquet hoặc ORC trên hạ tầng Object Storage (AWS S3, Google Cloud Storage, MinIO) đã trở thành giải pháp tiêu chuẩn để gom dữ liệu lớn với chi phí rẻ. Tuy nhiên, bất kỳ Kỹ sư Dữ liệu (Data Engineer) nào từng vận hành Data Lake truyền thống dựa trên Hive Metastore đều thấm thía những "cơn ác mộng" mang tính cố hữu:
Pipeline bị ngắt giữa chừng khiến dữ liệu rơi vào trạng thái đọc dở dang (Corrupted / Partial Data), làm người dùng cuối nhận số liệu sai lệch.
Không thể cập nhật hoặc sửa đổi bản ghi (UPDATE, DELETE, MERGE INTO) mà buộc phải ghi đè (Overwrite) toàn bộ phân vùng (Partition), gây tốn kém chi phí tính toán khổng lồ.
Thảm họa "hàng triệu file nhỏ" (Small File Problem) khiến các câu lệnh truy vấn bị nghẽn ở khâu liệt kê file (Listing Objects) thay vì đọc dữ liệu.
Khi thay đổi cấu trúc bảng (Schema Evolution) hoặc phân vùng lại bảng (Partition Evolution), toàn bộ thư mục dữ liệu phải bị ghi lại từ đầu.
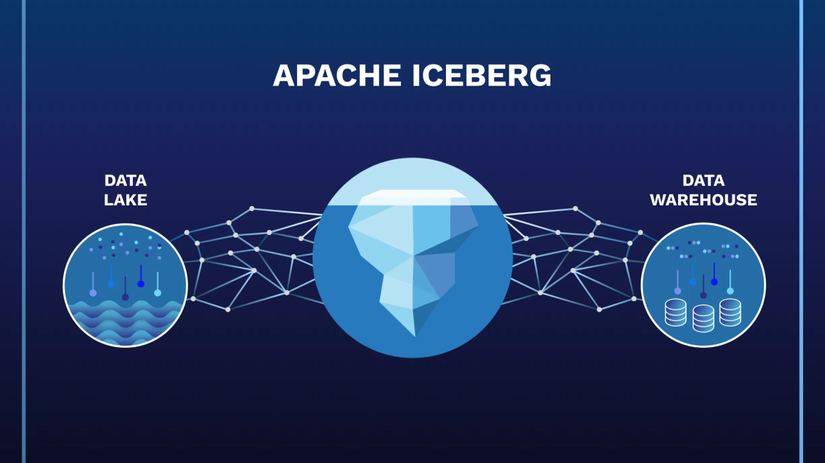
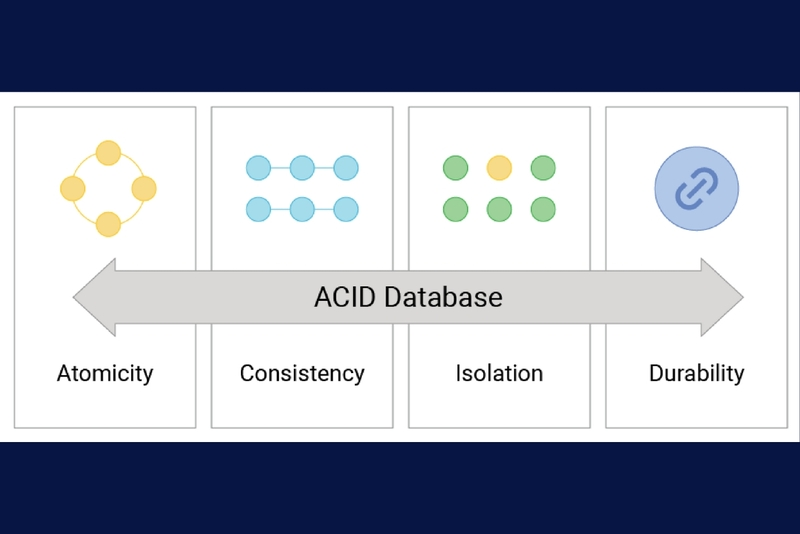
Sự ra đời của Open Table Format (Định dạng bảng mở) — tiêu biểu là Apache Iceberg — đã giải quyết triệt để các hạn chế này, chính thức biến Data Lake thô sơ thành một Lakehouse hiện đại: kết hợp chi phí lưu trữ siêu rẻ của Object Storage với các tính năng giao dịch mạnh mẽ tương tự cơ sở dữ liệu quan hệ (ACID Transactions, Time Travel, In-place Schema Evolution).
Bài viết này sẽ hướng dẫn bạn toàn bộ quy trình từ tư duy kiến trúc, thiết lập môi trường thực hành cục bộ với MinIO & Iceberg REST Catalog, cho đến các thao tác thực thi code PySpark và tối ưu hóa vận hành hệ thống chuẩn Production.
1. BẢN CHẤT KIẾN TRÚC: VÌ SAO APACHE ICEBERG THAY ĐỔI CUỘC CHƠI?
Trước khi viết bất kỳ dòng lệnh nào, bạn cần hiểu rõ cơ chế hoạt động bên dưới của Iceberg. Khác với Hive Metastore quản lý bảng ở cấp độ thư mục (Directory Level), Apache Iceberg quản lý bảng ở cấp độ file dữ liệu riêng lẻ (File Level) thông qua cây phân tầng siêu dữ liệu (Metadata Tree).
Cấu trúc phân tầng của Iceberg bao gồm 3 lớp độc lập:
Lớp Catalog (Iceberg Catalog):
Đóng vai trò là điểm tiếp xúc duy nhất, lưu trữ vị trí con trỏ (Pointer) trỏ tới file Metadata mới nhất của bảng.
Khi có một giao dịch mới hoàn tất thành công, Catalog thực hiện một thao tác hoán đổi nguyên tử (Atomic Swap) sang file Metadata mới.
Lớp Siêu dữ liệu (Metadata Layer):
Iceberg Metadata File (file .metadata.json): Lưu trữ toàn bộ lược đồ (Schema), cấu hình phân vùng (Partition Spec), danh sách các Snapshot và Snapshot hiện tại đang kích hoạt.
Manifest List File (file snap-*.avro): Đại diện cho một Snapshot cụ thể tại một thời điểm, lưu danh sách các Manifest Files cấu thành nên Snapshot đó.
Manifest File (file *-m0.avro): Lưu danh sách các file dữ liệu thực tế (Parquet), đi kèm các chỉ số thống kê cực kỳ chi tiết của từng cột (Min/Max values, Null count, NaN count) trong mỗi file.
Lớp Dữ liệu Thực (Data Layer):
Là các file Parquet chứa dữ liệu nghiệp vụ thực tế được lưu trên S3/MinIO.
Nhờ việc lưu sẵn các giá trị Min/Max của từng cột trong file Manifest, khi người dùng thực hiện truy vấn SQL có điều kiện lọc (ví dụ: WHERE created_at >= '2026-09-01'), công cụ truy vấn (Spark, DuckDB, Trino) chỉ cần đọc file Manifest để loại trừ ngay lập tức hàng ngàn file Parquet không liên quan mà không cần quét ổ cứng hay gửi yêu cầu liệt kê file tới S3. Đây chính là kỹ thuật Metadata Pruning.
2. CHUẨN BỊ MÔI TRƯỜNG THỰC HÀNH VỚI DOCKER COMPOSE
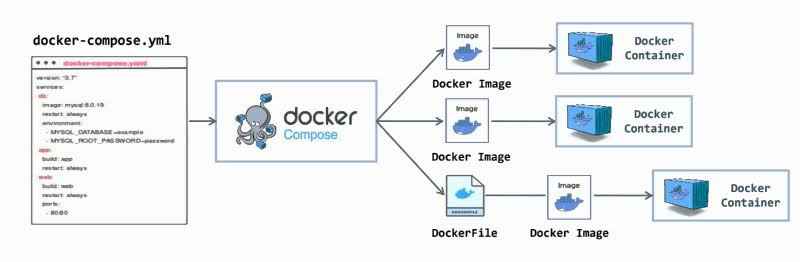
Để thực hành chuyển đổi một Data Lake sang Iceberg Lakehouse ngay trên máy cá nhân, chúng ta sẽ dựng cụm dịch vụ bao gồm:
MinIO: Đóng vai trò là Object Storage tương thích hoàn toàn với AWS S3 API.
Iceberg REST Catalog: Catalog chuẩn hiện đại và linh hoạt nhất hiện nay cho Apache Iceberg.
Apache Spark (Jupyter / PySpark Container): Động cơ tính toán phân tán để tương tác và xử lý bảng Iceberg.
Hãy tạo một file docker-compose.yml với nội dung như sau:
version: '3.8'

services:
  minio:
    image: minio/minio:RELEASE.2024-05-10T01-41-38Z
    container_name: iceberg-minio
    environment:
      - MINIO_ROOT_USER=admin
      - MINIO_ROOT_PASSWORD=password123
    ports:
      - "9000:9000"
      - "9001:9001"
    command: server /data --console-address ":9001"

  mc:
    image: minio/mc:latest
    container_name: iceberg-minio-setup
    depends_on:
      - minio
    entrypoint: >
      /bin/sh -c "
      until (/usr/bin/mc alias set myminio http://minio:9000 admin password123) do echo 'Waiting for MinIO...' && sleep 1; done;
      /usr/bin/mc mb myminio/warehouse;
      /usr/bin/mc anonymous set public myminio/warehouse;
      exit 0;
      "

  rest-catalog:
    image: apache/iceberg-rest-catalog:1.5.0
    container_name: iceberg-rest-catalog
    ports:
      - "8181:8181"
    environment:
      - CATALOG_WAREHOUSE=s3a://warehouse/
      - CATALOG_IO__IMPL=org.apache.iceberg.aws.s3.S3FileIO
      - CATALOG_S3_ENDPOINT=http://minio:9000
      - CATALOG_S3_PATH__STYLE__ACCESS=true
      - AWS_ACCESS_KEY_ID=admin
      - AWS_SECRET_ACCESS_KEY=password123
      - AWS_REGION=us-east-1

  spark-iceberg:
    image: tabulario/spark-iceberg:3.5.0_1.4.3
    container_name: iceberg-spark
    depends_on:
      - rest-catalog
      - minio
    environment:
      - SPARK_CONF_spark_sql_catalog_lakehouse=org.apache.iceberg.spark.SparkCatalog
      - SPARK_CONF_spark_sql_catalog_lakehouse_type=rest
      - SPARK_CONF_spark_sql_catalog_lakehouse_uri=http://rest-catalog:8181
      - SPARK_CONF_spark_sql_catalog_lakehouse_io-impl=org.apache.iceberg.aws.s3.S3FileIO
      - SPARK_CONF_spark_sql_catalog_lakehouse_s3_endpoint=http://minio:9000
      - SPARK_CONF_spark_sql_catalog_lakehouse_s3_path-style-access=true
      - SPARK_CONF_spark_sql_defaultCatalog=lakehouse
      - AWS_ACCESS_KEY_ID=admin
      - AWS_SECRET_ACCESS_KEY=password123
      - AWS_REGION=us-east-1
    ports:
      - "8888:8888"
      - "4040:4040"
Khởi chạy cụm dịch vụ bằng lệnh:
docker compose up -d
Sau khi toàn bộ dịch vụ khởi động thành công:
Giao diện quản trị MinIO: Truy cập http://localhost:9001 (Tài khoản: admin / Mật khẩu: password123). Bạn sẽ thấy một bucket mang tên warehouse đã được tạo sẵn.
Truy cập terminal của container Spark để thực thi lệnh:
docker exec -it iceberg-spark pyspark-sql
hoặc mở giao diện PySpark interactive:
docker exec -it iceberg-spark pyspark
3. TRIỂN KHAI THỰC CHIẾN TỪNG BƯỚC VỚI PYSPARK
Bây giờ, chúng ta sẽ bắt đầu chuỗi thao tác thực tế mô phỏng quy trình xử lý dữ liệu của một doanh nghiệp thương mại điện tử.
Bước 1: Khởi Tạo Bảng Iceberg Với Kỹ Thuật Hidden Partitioning
Một điểm yếu chí mạng của Hive Partitioning truyền thống là khi tạo thư mục ngày dạng /year=2026/month=09/day=25/, lập trình viên phải tự bóc tách các cột này từ trường thời gian. Người dùng khi truy vấn nếu chỉ viết WHERE order_timestamp >= '2026-09-25' thì Hive không thể nhận diện được phân vùng và sẽ quét toàn bộ bảng.
Iceberg giới thiệu khái niệm Hidden Partitioning (Phân vùng ẩn): Bạn chỉ định trực tiếp hàm biến đổi thời gian ngay trên trường gốc. Khi người dùng truy vấn trên trường gốc, Iceberg tự động ánh xạ tới phân vùng tương ứng.
Chạy đoạn mã PySpark sau để khởi tạo bảng:
from pyspark.sql import SparkSession

# Tạo Spark Session (đã được cấu hình catalog ngầm qua docker-compose)
spark = SparkSession.builder.getOrCreate()

# Tạo database nếu chưa tồn tại
spark.sql("CREATE NAMESPACE IF NOT EXISTS lakehouse.ecommerce")

# Tạo bảng Iceberg có phân vùng ẩn theo ngày và bucket ID
spark.sql("""
CREATE TABLE IF NOT EXISTS lakehouse.ecommerce.orders (
    order_id STRING,
    customer_id STRING,
    amount DOUBLE,
    status STRING,
    created_at TIMESTAMP
)
USING iceberg
PARTITIONED BY (days(created_at), bucket(4, customer_id))
TBLPROPERTIES (
    'write.format.default'='parquet',
    'write.parquet.compression-codec'='snappy',
    'format-version'='2'
)
""")

print("Bảng Iceberg orders đã được khởi tạo thành công!")
Lưu ý quan trọng: Tham số 'format-version'='2' cho phép kích hoạt chuẩn Iceberg v2, hỗ trợ các thao tác Row-Level Delete (xóa từng dòng) và ACID Transaction nhanh chóng mà không cần ghi lại cả file dữ liệu.
Bước 2: Nạp Dữ Liệu Ban Đầu (Initial Ingestion)
Tiến hành nạp 3 bản ghi ban đầu vào bảng:
spark.sql("""
INSERT INTO lakehouse.ecommerce.orders VALUES
('ORD_001', 'CUST_A', 150.0, 'COMPLETED', TIMESTAMP '2026-09-25 08:30:00'),
('ORD_002', 'CUST_B', 80.5,  'PENDING',   TIMESTAMP '2026-09-25 09:15:00'),
('ORD_003', 'CUST_C', 210.0, 'PROCESSING',TIMESTAMP '2026-09-25 10:00:00')
""")

# Kiểm tra dữ liệu hiện tại
spark.sql("SELECT * FROM lakehouse.ecommerce.orders").show()
Lúc này, hãy mở giao diện MinIO tại http://localhost:9001, vào bucket warehouse/ecommerce/orders/. Bạn sẽ thấy:
Thư mục metadata/: Chứa file .metadata.json, file snap-*.avro và *-m0.avro.
Thư mục data/: Chứa các file Parquet dữ liệu thực tế được chia theo phân vùng.
Bước 3: Thực Thi ACID Transaction Với MERGE INTO (Upsert Logic)
Trong hệ thống bán hàng thực tế, đơn hàng ORD_002 từ trạng thái PENDING sẽ được chuyển thành COMPLETED, đồng thời có thêm một đơn hàng mới ORD_004.
Nếu ở Data Lake truyền thống, bạn phải đọc toàn bộ phân vùng ngày 2026-09-25, lọc bỏ dòng cũ, nối dòng mới vào và ghi đè toàn bộ thư mục. Với Apache Iceberg, bạn chỉ cần thực hiện một câu lệnh MERGE INTO:
# Tạo bảng dữ liệu thay đổi từ nguồn CDC (Change Data Capture)
spark.sql("""
CREATE OR REPLACE TEMPORARY VIEW staging_cdc_updates AS
SELECT 'ORD_002' AS order_id, 'CUST_B' AS customer_id, 80.5 AS amount, 'COMPLETED' AS status, TIMESTAMP '2026-09-25 09:15:00' AS created_at
UNION ALL
SELECT 'ORD_004' AS order_id, 'CUST_D' AS customer_id, 300.0 AS amount, 'COMPLETED' AS status, TIMESTAMP '2026-09-25 10:30:00' AS created_at
""")

# Thực thi ACID MERGE INTO
spark.sql("""
MERGE INTO lakehouse.ecommerce.orders target
USING staging_cdc_updates source
ON target.order_id = source.order_id
WHEN MATCHED THEN
    UPDATE SET
        target.status = source.status,
        target.amount = source.amount
WHEN NOT MATCHED THEN
    INSERT (order_id, customer_id, amount, status, created_at)
    VALUES (source.order_id, source.customer_id, source.amount, source.status, source.created_at)
""")

print("Thao tác MERGE INTO hoàn tất an toàn với chuẩn giao dịch ACID!")
spark.sql("SELECT * FROM lakehouse.ecommerce.orders ORDER BY order_id").show()
Đơn hàng ORD_002 đã được cập nhật thành COMPLETED mà không làm khóa bảng và không ảnh hưởng tới bất kỳ câu lệnh đọc nào khác đang chạy song song.
Bước 4: Ứng Dụng Time Travel (Du Hành Thời Gian Của Dữ Liệu)
Mỗi lần có thao tác ghi, cập nhật hoặc xóa dữ liệu, Iceberg sẽ tạo ra một Snapshot mới không thể chỉnh sửa (Immutable Snapshot). Tính năng này mang lại khả năng "du hành thời gian", giúp bạn kiểm toán hoặc quay ngược dữ liệu khi phát hiện có sai sót.
Đầu tiên, hãy kiểm tra danh sách Snapshot trong bảng lịch sử:
spark.sql("""
SELECT committed_at, snapshot_id, operation, summary['total-records'] as total_records
FROM lakehouse.ecommerce.orders.snapshots
ORDER BY committed_at ASC
""").show(truncate=False)
Kết quả sẽ hiển thị ít nhất 2 snapshot:
Snapshot 1 sinh ra từ lệnh INSERT ban đầu (3 records).
Snapshot 2 sinh ra từ lệnh MERGE INTO (4 records).
Để xem dữ liệu chính xác ở thời điểm Snapshot 1 (trước khi đơn hàng ORD_002 bị đổi trạng thái):
# Lấy snapshot_id đầu tiên từ lịch sử
first_snapshot_id = spark.sql("SELECT snapshot_id FROM lakehouse.ecommerce.orders.snapshots ORDER BY committed_at ASC LIMIT 1").collect()[0]['snapshot_id']

# Truy vấn Time Travel theo snapshot_id
spark.sql(f"""
SELECT * FROM lakehouse.ecommerce.orders VERSION AS OF {first_snapshot_id}
ORDER BY order_id
""").show()
Bạn sẽ thấy đơn hàng ORD_002 quay trở về trạng thái PENDING và đơn ORD_004 hoàn toàn chưa tồn tại.
Ngoài ra, Iceberg còn hỗ trợ truy vấn theo mốc thời gian (Timestamp Time Travel):
spark.sql("""
SELECT * FROM lakehouse.ecommerce.orders
TIMESTAMP AS OF '2026-09-25 08:35:00'
""").show()
Bước 5: Phục Hồi Dữ Liệu Khi Gặp Sự Cố (Rollback To Snapshot)
Giả sử một kịch bản tồi tệ xảy ra: Một kỹ sư dữ liệu vô tình chạy nhầm lệnh cập nhật làm sai lệch toàn bộ cột số tiền:
# Kịch bản phá hoại dữ liệu ngoài ý muốn
spark.sql("UPDATE lakehouse.ecommerce.orders SET amount = 0")
spark.sql("SELECT * FROM lakehouse.ecommerce.orders").show()
Ở Data Lake truyền thống, bạn sẽ phải phục hồi lại toàn bộ bản backup từ S3 (mất nhiều giờ). Với Apache Iceberg, bạn chỉ mất đúng 1 giây để rollback toàn bộ bảng về Snapshot hợp lệ gần nhất trước đó bằng thủ tục hệ thống:
# Lấy snapshot_id ngay trước sự cố (Snapshot thứ 2)
safe_snapshot_id = spark.sql("""
SELECT snapshot_id FROM lakehouse.ecommerce.orders.snapshots
WHERE operation = 'overwrite' OR operation = 'append'
ORDER BY committed_at DESC LIMIT 1 OFFSET 1
""").collect()[0]['snapshot_id']

# Khôi phục trạng thái bảng
spark.sql(f"""
CALL lakehouse.system.rollback_to_snapshot('ecommerce.orders', {safe_snapshot_id})
""")

print("Phục hồi hệ thống thành công!")
spark.sql("SELECT * FROM lakehouse.ecommerce.orders ORDER BY order_id").show()
Toàn bộ số liệu đơn hàng đã được khôi phục nguyên trạng.
4. TỰ ĐỘNG HÓA BẢO TRÌ BẢNG LAKEHOUSE: COMPACTION VÀ EXPIRE SNAPSHOTS
Một hệ thống Lakehouse chạy trên Production nếu không được bảo trì sẽ nhanh chóng đối mặt với hai vấn đề lớn:
Nhiều file nhỏ phát sinh: Do cơ chế Row-Level Delete và các tác vụ nạp dữ liệu Streaming/Micro-batch liên tục.
Chi phí lưu trữ phình to: Do các file Parquet của các Snapshot cũ trong quá khứ không bao giờ tự biến mất.
Dưới đây là hai tác vụ bảo trì định kỳ bắt buộc mà một Kỹ sư Dữ liệu phải lên lịch tự động hóa:
1. Dồn Dịch File Nhỏ (Compaction / Rewrite Data Files)
Iceberg cung cấp thủ tục rewrite_data_files để đọc các file nhỏ nằm rải rác và gộp chúng lại thành các file Parquet kích thước lớn (chuẩn 128MB - 512MB) mà vẫn giữ nguyên tính toàn vẹn của bảng:
# Chạy thủ tục nén và gộp file Parquet
spark.sql("""
CALL lakehouse.system.rewrite_data_files(
    table => 'ecommerce.orders',
    strategy => 'binpack',
    options => map(
        'max-file-size-bytes', '536870912', -- 512 MB
        'min-file-size-bytes', '134217728', -- 128 MB
        'target-file-size-bytes', '268435456' -- 256 MB
    )
)
""").show()
Thao tác này diễn ra ngầm (asynchronously) và sinh ra một snapshot mới, người dùng đang truy vấn dữ liệu đồng thời hoàn toàn không bị ảnh hưởng.
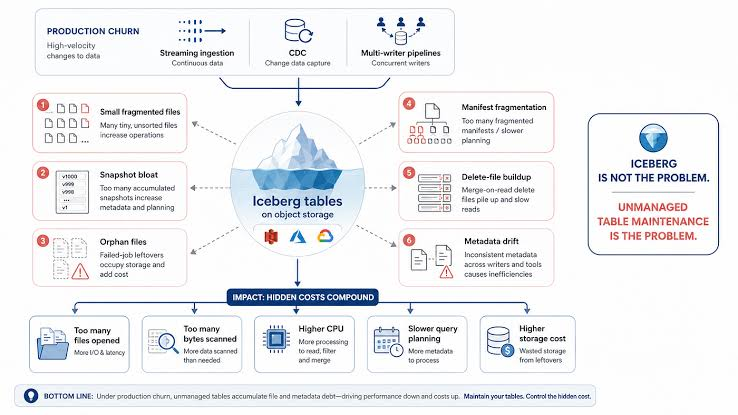
2. Gỡ Bỏ Snapshot Hết Hạn Và Dọn Rác (Expire Snapshots & Remove Orphan Files)
Để giải phóng dung lượng ổ cứng trên S3/MinIO, định kỳ (ví dụ mỗi tuần một lần), hãy thiết lập thời hạn lưu trữ snapshot (ví dụ: chỉ giữ lại lịch sử trong 7 ngày gần nhất):
# Xóa bỏ các snapshot cũ hơn 7 ngày (giả lập xóa các snapshot trước thời điểm hiện tại)
spark.sql("""
CALL lakehouse.system.expire_snapshots(
    table => 'ecommerce.orders',
    older_than => TIMESTAMP '2026-09-25 10:50:00',
    retain_last => 2
)
""").show()

# Quét và xóa các file mồ côi (file Parquet rác không còn thuộc snapshot nào)
spark.sql("""
CALL lakehouse.system.remove_orphan_files(
    table => 'ecommerce.orders'
)
""").show()
Lúc này, các file Parquet của những phiên bản cũ đã được MinIO thu hồi vĩnh viễn, tối ưu hóa triệt để chi phí hạ tầng Cloud.
5. NHỮNG NGUYÊN TẮC CỐT TỬ KHI TRIỂN KHAI TRÊN CLOUD PRODUCTION (AWS S3)
Khi chuyển giao kiến trúc này từ môi trường thực hành lên môi trường sản xuất thực tế trên đám mây (AWS / GCP / Azure), bạn cần chú ý 4 nguyên tắc sau:
Lựa chọn Catalog phù hợp:
Trong hệ sinh thái AWS, bạn có thể sử dụng AWS Glue Data Catalog làm Iceberg Catalog (bật cờ tương thích Iceberg).
Tuy nhiên, xu hướng tiêu chuẩn mở hiện đại đang dịch chuyển mạnh sang Apache Polaris hoặc Iceberg REST Catalog tự host trên Kubernetes (EKS) để tránh hiện tượng bị khóa chặt vào một nhà cung cấp đám mây (Vendor Lock-in).
Áp dụng chiến lược S3 FileIO chuyên dụng:
Luôn sử dụng thư viện org.apache.iceberg.aws.s3.S3FileIO thay vì org.apache.hadoop.fs.s3a.S3AFileSystem. S3FileIO tối ưu hóa đường truyền mạng, bỏ qua các tầng trừu tượng cồng kềnh của Hadoop và giảm thiểu tối đa các lỗi liên quan đến tính nhất quán của S3.
Cẩn trọng với tần suất Commit khi Streaming:
Nếu dùng Spark Streaming hoặc Flink nạp dữ liệu vào bảng Iceberg, không nên commit quá dày (ví dụ dưới 10 giây). Hãy duy trì khoảng cách commit từ 1 đến 5 phút để tránh làm bùng nổ số lượng file siêu dữ liệu (Manifest Bloat).
Tích hợp kiểm định tự động vào DAG Airflow:
Hãy đóng gói các thủ tục bảo trì rewrite_data_files và expire_snapshots thành một task chạy vào đêm muộn trên Apache Airflow để hệ thống luôn tự dọn dẹp và duy trì hiệu năng cao nhất.
KẾT LUẬN
Việc chuyển dịch từ Data Lake truyền thống sang Open Table Format với Apache Iceberg là một bước tiến vượt bậc trong kỹ nghệ dữ liệu. Bằng cách tái cấu trúc siêu dữ liệu và hỗ trợ đầy đủ chuẩn ACID, Apache Iceberg biến hạ tầng lưu trữ Object Storage giá rẻ thành một kho dữ liệu phân tích mạnh mẽ, linh hoạt và đáng tin cậy.
Làm chủ quy trình xây dựng bảng phân vùng ẩn, vận hành các câu lệnh MERGE INTO, kiểm soát rủi ro bằng tính năng Time Travel và tự động hóa chu trình bảo trì dọn dẹp chính là tấm hộ chiếu vững chắc đưa bạn từ một người làm dữ liệu đơn thuần trở thành một Lakehouse Architect chuyên nghiệp, sẵn sàng đón đầu các tiêu chuẩn công nghệ dữ liệu tiên tiến nhất.
All rights reserved