Claude và GPT: ba mô hình, 180 lần gọi
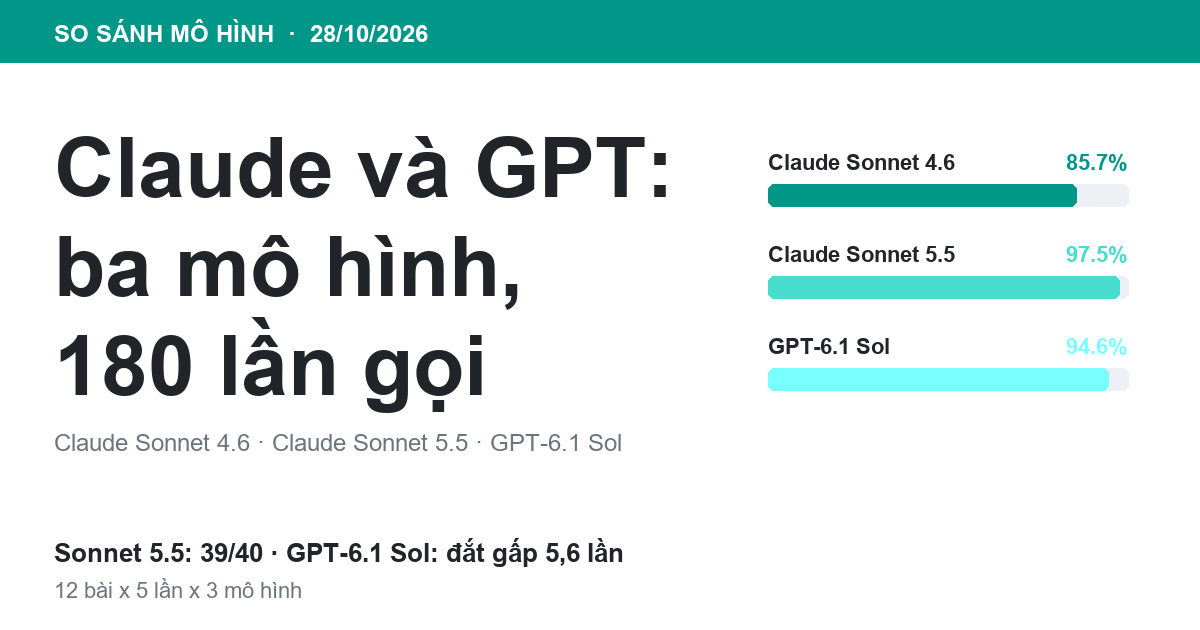
12 bài, 5 lần mỗi bài, 3 mô hình. Mỗi lần gọi tốn từ 0,0033 đến 0,0265 USD.
Đơn giá theo token xem tại trang giá Sonnet 4.6.
Mình dùng ba mô hình cho ba loại việc khác nhau: viết nội dung ngắn, bóc tách trường dữ liệu từ ticket, và thỉnh thoảng giải mấy bài toán nhỏ.
Mỗi lần đổi mô hình, mình lại phải kiểm tra lại từ đầu xem nó có hỏng ở đâu không. Một lần thử thì gần như không nói được gì: nó chỉ cho biết mẫu đó đúng hay sai.
Thế nên mình làm một việc hơi tốn công: gửi cùng một bài năm lần, cho cả ba mô hình, tổng cộng 180 lần gọi trong một buổi chiều.
Vì sao một lần thử là chưa đủ
Nếu chỉ gọi một lần, bạn không phân biệt được hai chuyện rất khác nhau: mô hình gặp xui, hay mô hình có tật.
Với lỗi ngẫu nhiên, cách xử lý là gọi lại. Với lỗi có hệ thống, cách xử lý là đổi mô hình hoặc thêm một lớp kiểm tra. Hai hướng này chênh nhau rất nhiều về công sức, nên đoán sai sẽ tốn tiền.
Năm lần là đủ để nhìn thấy cùng một lỗi lặp lại hai lần, mà vẫn kịp làm trong một buổi.
Cách mình kiểm tra
Mười hai bài, chia làm hai nhóm. Tám bài có đáp án rõ ràng nên chấm tự động được: một bài tính, một bài xác suất, một bài định nghĩa có giới hạn ký tự, vài bài về định dạng đầu ra.
Bốn bài còn lại là viết lại mã và viết lại văn, phải đọc bằng mắt, nên mình để ngoài tỉ lệ đạt.
| Mô hình | Đạt (tự động) | Trung vị độ trễ | Chi phí mỗi lần gọi |
|---|---|---|---|
| Claude Sonnet 4.6 | 30/35 | 3,29 giây | 0,0033 USD |
| Claude Sonnet 5.5 | 39/40 | 2,81 giây | 0,0047 USD |
| GPT-6.1 Sol | 35/37 | 6,19 giây | 0,0265 USD |
Mẫu số khác nhau vì 13 trong 180 lần gọi bị lỗi mạng và bị loại. Nếu ép tất cả về mẫu 40 thì bạn đang so sánh đường truyền, không phải so sánh mô hình.
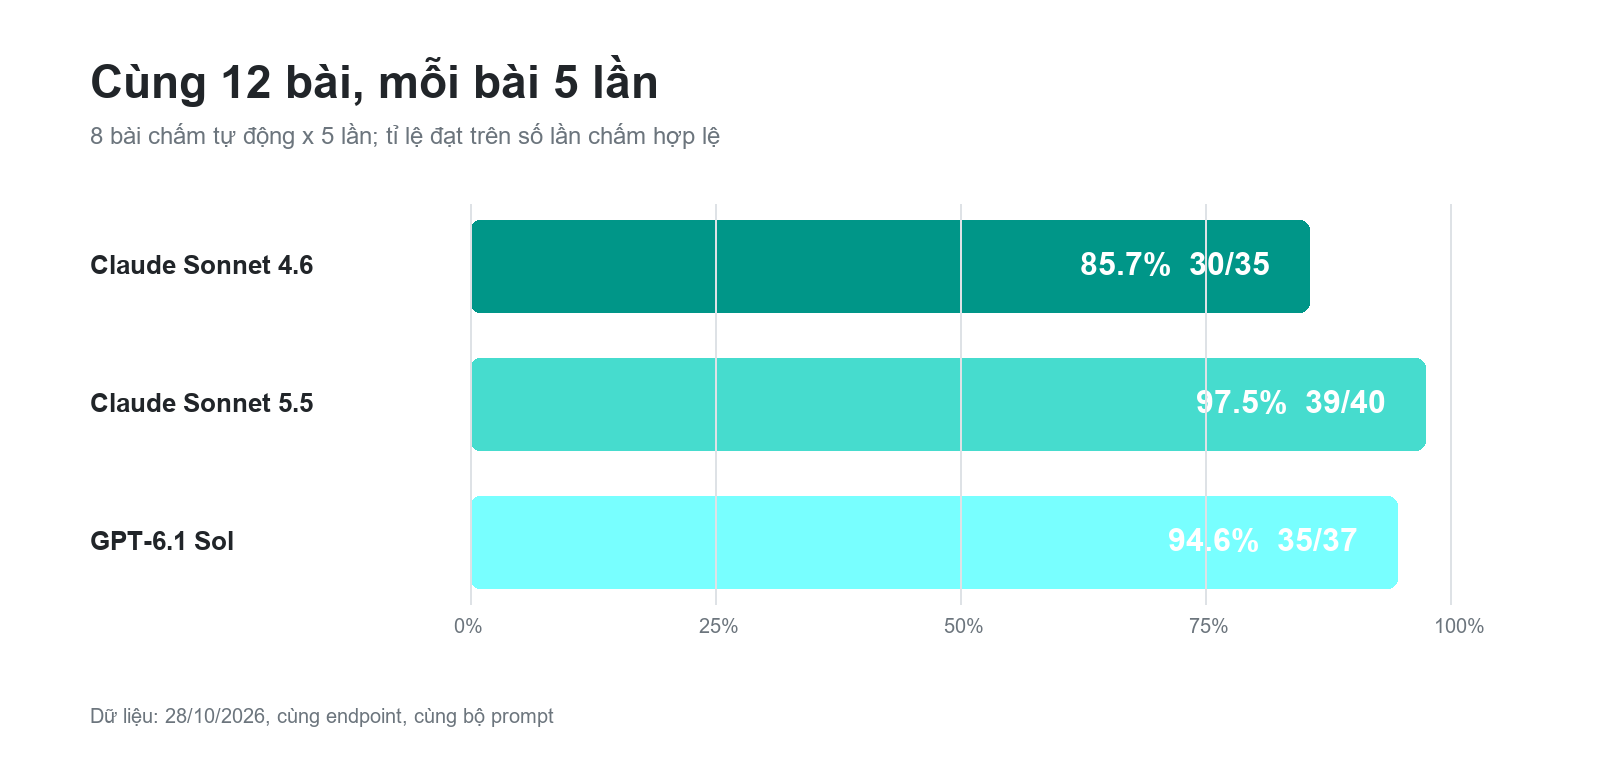
Tỉ lệ đạt tính trên số lần chấm hợp lệ, mỗi bài 5 lần.
Khác biệt thứ nhất: giới hạn 60 ký tự
Bài này hơi lắt léo: giải thích MoE trong không quá 60 ký tự, và không được dùng chữ "chuyên gia".
Để dễ hình dung, MoE là kiểu kiến trúc chia mạng thành nhiều mạng con, mỗi lần chỉ đánh thức một vài mạng con trong số đó. Yêu cầu ở đây không phải định nghĩa cho hay, mà là giữ được giới hạn.
Ba mô hình trả về độ dài 65, 58 và 48 ký tự. Claude Sonnet 4.6 vượt năm ký tự, và phần vượt nằm ở mấy cụm bổ nghĩa như "cơ chế cổng" hay "chọn động".
Mình gửi thêm bốn lần. Độ dài lần lượt: 65, 62, 68, 66 và 70. Không lần nào xuống dưới 60.
Đây không phải lỗi đếm. Mô hình đặt "nói cho đủ" lên trước "giữ đúng giới hạn". Khi viết bài, đó là điểm cộng. Khi chạy hàng loạt, đó là hàng lỗi: câu nào cũng phải sửa tay, mà công sửa tay đắt hơn tiền gọi API.
Khác biệt thứ hai: sai một lần trong năm
Bài xác suất: lấy ba số khác nhau từ 1 đến 5, tính xác suất tổng là số chẵn. Đáp án là 3/5.
Claude Sonnet 5.5 đúng bốn trên năm lần. Lần sai, nó lập luận như sau (trích):
Ba số đều chẵn: chỉ có 2 và 4, không lấy được ba số, 0 cách. Một số lẻ và hai số chẵn: C(3,1)×C(2,2)=3 cách. Vậy xác suất là 3/10.
Nó đếm nhầm tổ hợp: đáng lẽ là "hai lẻ một chẵn" thì nó làm "một lẻ hai chẵn". Số cách giảm một nửa, đáp án cũng giảm một nửa.
Đây chính là lý do phải lặp. Nếu chỉ xem một lần, mô hình này hoặc trông hoàn hảo, hoặc trông không dùng được. Nhìn cả năm lần thì nó là 39/40, sai đúng một bài có đáp án rõ ràng — và cách xử lý là gọi lại.
Khác biệt thứ ba: cùng giá niêm yết, hóa đơn gấp 5,6 lần
Claude Sonnet 5.5 và GPT-6.1 Sol có cùng giá niêm yết: 2 USD mỗi triệu token đầu vào, 10 USD mỗi triệu token đầu ra.
Nhưng chi phí thực tế mỗi lần gọi là 0,0047 USD và 0,0265 USD. Cùng một bảng giá, hóa đơn chênh 5,6 lần.
Chênh lệch không nằm ở đơn giá mà ở lượng tiêu thụ cho mỗi bài: Sol xử lý nhiều bước hơn giữa lúc nhận câu hỏi và lúc trả lời.
Và khoản tiền thêm đó không mua được độ chính xác. Ở bài hình elip, đáp án là 16/5, Sol chỉ trả về 4/5 trong hai trên năm lần. Hai mô hình Claude làm đúng cả năm lần.
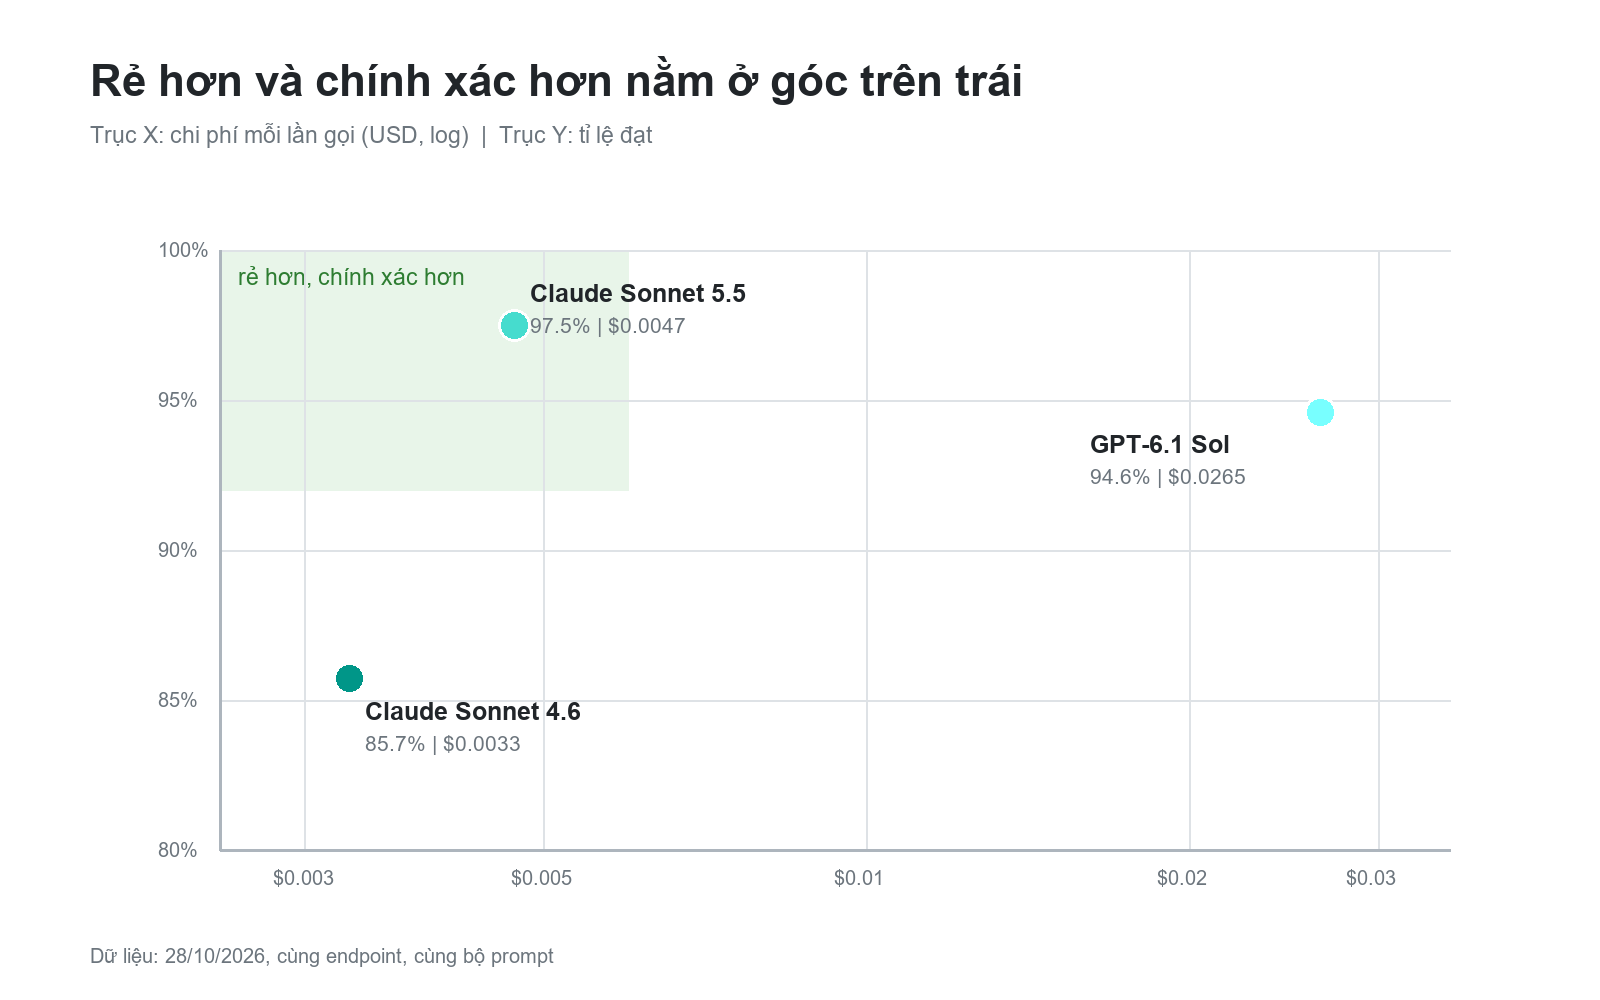
Trục ngang là chi phí (thang log), trục dọc là tỉ lệ đạt; vùng xanh là hướng rẻ hơn và chính xác hơn.
Đắt hơn, chậm hơn, và sai ở đúng bài mà hai mô hình kia làm đúng: đó không phải bản cao cấp, mà là một cách làm khác, và cách đó không hợp với việc này.
Bài toán thật: 20 ticket, 100 ô
Mười hai bài nhỏ là bài kiểm tra, không phải công việc. Nên mình chạy thêm một dạng gần thực tế hơn: 20 ticket hỗ trợ, mỗi ticket bóc ra 5 trường, tổng cộng 100 ô dữ liệu.
Cả ba mô hình điền đúng cả 100 ô. Độ chính xác không tách được mô hình nào.
Thời gian thì có: Sonnet 5.5 mất 7,5 giây, GPT-6.1 Sol 29,3 giây, Sonnet 4.6 37,9 giây.
Nửa phút mỗi lần nghe không đáng kể. Nhưng 10.000 lần một ngày thì chênh hơn 84 giờ, tức hơn ba ngày chờ đợi hoặc trả tiền.
Tự làm lại trên dữ liệu của bạn
Không cần đúng mười hai bài như trên. Cách rẻ nhất là lấy ba việc bạn làm hằng ngày, mỗi việc một prompt cố định, rồi gửi năm lần.
Ghi lại bốn thứ: số lần đúng, bài nào sai, thời gian trung vị, và chi phí mỗi lần gọi. Bốn con số này đủ để quyết định, còn hơn mọi bảng xếp hạng chung.
Một lưu ý nhỏ về giới hạn ký tự: đừng chỉ dựa vào prompt. Nếu API cho phép đặt max_tokens, hãy đặt, nhưng biết rằng nó cắt chứ không dạy mô hình viết ngắn. Câu bị cắt vẫn phải sửa tay, chỉ là kiểu sửa khác.
Và nếu kết quả chỉ chênh một hai lần đúng trên tổng số ba mươi, đừng đổi mô hình. Đó là nhiễu, không phải tín hiệu.
Nên chọn ai
Với việc có giới hạn cứng về độ dài hoặc định dạng — viết hàng loạt, đầu ra có cấu trúc, dữ liệu trả về cho API — Claude Sonnet 5.5 là lựa chọn rõ nhất: không lần nào vượt giới hạn, độ trễ trung vị ngắn nhất, chi phí mỗi lần gọi thấp nhất trong ba.
Với việc viết một lần rồi có người sửa, giữ Claude Sonnet 4.6 vẫn hợp lý. Câu trả lời dài và đầy đủ hơn ở bối cảnh đó là nguyên liệu, không phải lỗi.
GPT-6.1 Sol không phải bản thay thế rẻ hơn. Giá niêm yết bằng nhau, tiền thực trả gấp 5,6 lần, và sai hai lần ở một bài tính đơn giản. Ai chọn nó nên có lý do khác chữ "rẻ".
Những gì chưa kiểm tra
Toàn bộ số liệu trên là văn bản một lượt, đầu vào ngắn.
Ngữ cảnh dài, hội thoại nhiều lượt, gọi công cụ và hiểu hình ảnh đều chưa thử. Ba mô hình có cửa sổ ngữ cảnh khác nhau — 200K, 1M và 922K token — nhưng đó là thông số, không phải kết quả đo, và bảng trên không nói gì về chúng.
Bốn bài do người chấm nên không nằm trong tỉ lệ. Mười ba lần gọi lỗi mạng đã bị loại. Giá đọc từ danh mục mô hình ngày 28/10/2026, hóa đơn thực tế phụ thuộc mức dùng.
All Rights Reserved